Reingefallen auf KI-Abzocke? Das muß nicht sein...

jet2

jet2

Tonträger
Registriert
07.09.11
Beiträge
17.585
Reaktionen
12.392
Ort
Berlin
Punkte
61.087
na, welcher hobby- oder vermeintliche pro-ai-"programmierer" ist denn in die abo-falle von openai, anthropic, google und konsorten getappt?
mal ehrlich - wer hat massig geld dafür bezahlt, seine daten und ideen bei den platzhirschen abzugeben?

@BodoH - mich würde ja mal brennend interessieren, wieviel geld du für monatliche abos ausgibst...

bei mir läuft ki schon seit ner weile nur noch lokal.
da zahle ich nur die stromkosten und gebe meine ideen nicht weiter.
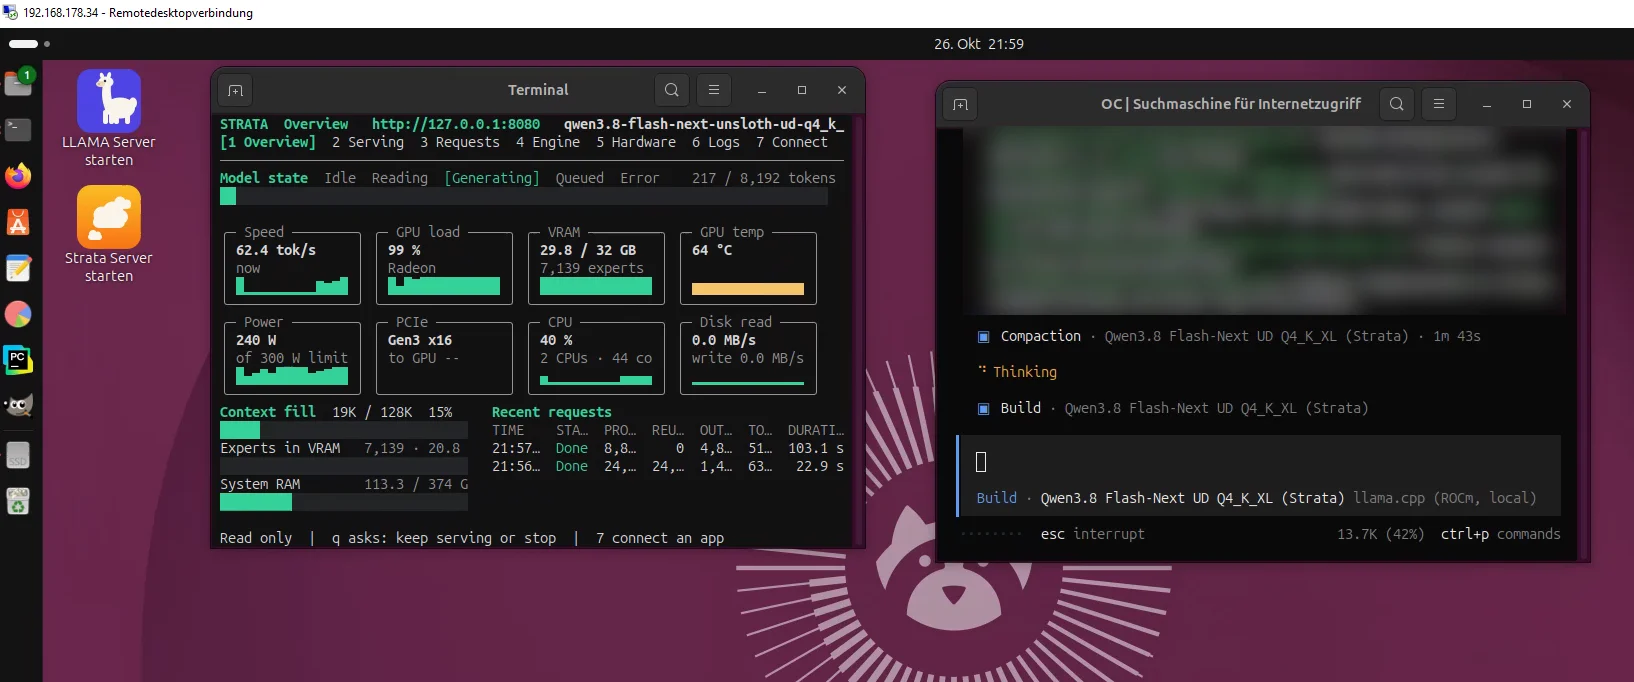
seit heute über einen lokalen strata.
bis 70 tokens/s mit einem 140gb großen modell in sehr hoher qualität.
... so schnell, wie das llm ausgibt, kann ich gar nicht lesen ..

remote-desktop über wireguard-vpn auf meinen homerechner.
btw. - den rechner habe ich gebraucht gekauft.
(alter dell-server - das mit dem ram war allerdings schon ein schnäppchen)
plus ne neue radeon gpu - zusammen für unter 3500 euro.
btw. wer jetzt noch nvidia grafikarten kauft, ist bekloppt.

1793052603668.webp
 
  • Interessant
Reaktionen: danielrast

Hab grad keine 3.5k über, deshalb ne Sub um hauptsächlich beruflich damit zu arbeiten. Damit komm ich dann über 6 Jahre weit.

Edit: Bin aber weder Hobby noch Pro-Programmierer sondern nutze es als Unterstützung in einem anderen Bereich.
 
Ist mit informed consent als Erwachsener einen Vertrag abschließen bereits Abzocke?
 
  • Danke
Reaktionen: Dondelinger
na, welcher hobby- oder vermeintliche pro-ai-"programmierer" ist denn in die abo-falle von openai, anthropic, google und konsorten getappt?
mal ehrlich - wer hat massig geld dafür bezahlt, seine daten und ideen bei den platzhirschen abzugeben?

@BodoH - mich würde ja mal brennend interessieren, wieviel geld du für monatliche abos ausgibst...

bei mir läuft ki schon seit ner weile nur noch lokal.
da zahle ich nur die stromkosten und gebe meine ideen nicht weiter.
seit heute über einen lokalen strata.
bis 70 tokens/s mit einem 140gb großen modell in sehr hoher qualität.
... so schnell, wie das llm ausgibt, kann ich gar nicht lesen ..

remote-desktop über wireguard-vpn auf meinen homerechner.
btw. - den rechner habe ich gebraucht gekauft.
(alter dell-server - das mit dem ram war allerdings schon ein schnäppchen)
plus ne neue radeon gpu - zusammen für unter 3500 euro.
btw. wer jetzt noch nvidia grafikarten kauft, ist bekloppt.


Anhang anzeigen 171711
Wie monetarisieren sich jetzt die < 3.500 €? Just for fun?
 
@BodoH - mich würde ja mal brennend interessieren, wieviel geld du für monatliche abos ausgibst...
Ich nutze den Plus Plan von ChatGPT für 23 Euro im Monat. Der Pro Plan mit 103 Euro/Monat ist mir zu teuer.
Darin enthalten ist die Nutzung von deren Codex (ist wie Claude Code), der wäre spezieller für Softwareentwicklung geeignet, aber ich nutze da nur das freie Kontingent zur Kontrolle von ChatGPT. Claude nutze ich nur kostenlos, ebenfalls als Kontrollinstanz.

Dazu kommen Kosten durch Github, die können 0 Euro betragen (man hat da freie Actions), aber durch nicht öffentliche Repros und hohem Action Verbrauch auch teurer werden. Diesen Monat liege ich momentan bei 28 Euro. Daher Ausgaben 23+28 Euro=51 Euro gesamt diesen Monat.
 
  • Interessant
  • Danke
Reaktionen: mWermut, Ethersis und Ngoc
Wie bekommst Du mit nur 32GB VRAM 70 Tokens/Min? Mit einem Apple M5 und 128GB (auf die CPU und GPU zugreifen) ja, aber so? Erklär mal bitte.
 
na, welcher hobby- oder vermeintliche pro-ai-"programmierer" ist denn in die abo-falle von openai, anthropic, google und konsorten getappt?
3.500 € für einen gebrauchten Server mit 374 GB RAM, einer neuen Radeon-Grafikkarte und einer lokalen KI – dazu Stromverbrauch, Einrichtung, Wartung und die Beschäftigung mit den Modellen selbst. Dei Hardware ist beeindruckend. Das wären ca. 12,7 Jahre Abonnementgebühren bei ChatGPT :D

70 Tokens pro Sekunde sind schön. Aber wenn das Modell bei komplexem C++-Code, Audioprogrammierung oder VST3-Hostproblemen Fehler produziert, hilft die Geschwindigkeit aber wenig.
Für meine 125A-Entwicklung wären mir weniger Programmierfehler und zuverlässige Audits wesentlich wichtiger als 70 Tokens pro Sekunde^^

Allerdings vermute ich, dass dir gerade diese technische Bastelei Spaß macht. Für manche ist die lokale KI-Infrastruktur ja ein eigenes Hobby. Hab das Model auch gefunden: https://github.com/Niko1221/Strata

Was hast du vor? Das Weiße Haus hacken? :D Für paar Plugins wäre das doch völlig überdimensioniert, oder?
 
na, welcher hobby- oder vermeintliche pro-ai-"programmierer" ist denn in die abo-falle von openai, anthropic, google und konsorten getappt?
mal ehrlich - wer hat massig geld dafür bezahlt, seine daten und ideen bei den platzhirschen abzugeben?

@BodoH - mich würde ja mal brennend interessieren, wieviel geld du für monatliche abos ausgibst...

bei mir läuft ki schon seit ner weile nur noch lokal.
da zahle ich nur die stromkosten und gebe meine ideen nicht weiter.
seit heute über einen lokalen strata.
bis 70 tokens/s mit einem 140gb großen modell in sehr hoher qualität.
... so schnell, wie das llm ausgibt, kann ich gar nicht lesen ..

remote-desktop über wireguard-vpn auf meinen homerechner.
btw. - den rechner habe ich gebraucht gekauft.
(alter dell-server - das mit dem ram war allerdings schon ein schnäppchen)
plus ne neue radeon gpu - zusammen für unter 3500 euro.
btw. wer jetzt noch nvidia grafikarten kauft, ist bekloppt.


Anhang anzeigen 171711
warte mal gta 6 und die neue Nvidia generation ab. dann sieht das wieder anders aus.
 
Soll ja Leute geben die sich nicht mit den Innereien der Programmierung befassen wollen. Für die wäre es sicher nicht sinnvoll sich eine eigene KI Infrastruktur zusammenzubauen einschliesslich remote Zugang, um die dann auch von überall nutzen zu können.

3500 für sowas? Und den Ärger damit am Hals? Super Deal. Aber nur für Masochisten.. (;
 
  • #10
Wahnsinn was KI für einen Geldfluss generiert.
 
  • Danke
Reaktionen: Ethersis
  • #11
Man braucht eben um einen Hit zu produzieren heutzutage amtliche Server. Amtliche Preamps war gestern.
 
  • Haha
Reaktionen: danielrast und schrubber23
  • #12
Soll ja Leute geben die sich nicht mit den Innereien der Programmierung befassen wollen. Für die wäre es sicher nicht sinnvoll sich eine eigene KI Infrastruktur zusammenzubauen einschliesslich remote Zugang, um die dann auch von überall nutzen zu können.
ja, du tippst wahrscheinlich lieber bei google oder chatgpt über dein handy ein...
sorry, alle deine daten werden weiter verarbeitet, dein verhalten getrackt und das, was du danach zu sehen bekommst, limitiert.

ich mach einen vpn tunnel auf und frage mein llm.
wenn ich eine internetsuche brauche, geht das nicht über google, sondern über eine lokal implementierte searxng search engine.

3500 für sowas? Und den Ärger damit am Hals? Super Deal. Aber nur für Masochisten.. (;
welcher ärger bitte? es hat ein paar stunden gedauert, das ding einzurichten. das läuft wie ne eins.

warte mal gta 6 und die neue Nvidia generation ab. dann sieht das wieder anders aus.
jetzt läßt nvidia gerade die rtx5090 fallen. und die allein kostet bei idealo zwischen 7600 und 10000 euro.
kann aber nicht viel mehr als die radeon r9700, die ich noch für 1600 euro bekommen habe.
und unsere bundesregierung will jetzt gerade mit nvidia fette verträge machen...
da fragt man sich schon, wer da noch zurechnungsfähig ist.

3.500 € für einen gebrauchten Server mit 374 GB RAM, einer neuen Radeon-Grafikkarte und einer lokalen KI – dazu Stromverbrauch, Einrichtung, Wartung und die Beschäftigung mit den Modellen selbst. Dei Hardware ist beeindruckend. Das wären ca. 12,7 Jahre Abonnementgebühren bei ChatGPT :D
upps kollege, dat is aber ne milchmädchen-rechnung.
bei 50 euro im monat, die du allein für deine pluginentwicklung ausgibst, komme ich auf etwas über 5 jahre.
und dafür gibst du deine ideen, deine daten und dein persönlichkeitsprofil an der kasse ab.
entscheidend ist auch, dass du von den zukünftigen preisen (die todsicher steigen werden) abhängig bist.
und du willst mir hier auch nicht ernsthaft verkaufen, dass du mit den limitierungen der modellbenutzung beim 23 euro abo dauerhaft zurechtkommst...

Allerdings vermute ich, dass dir gerade diese technische Bastelei Spaß macht. Für manche ist die lokale KI-Infrastruktur ja ein eigenes Hobby. Hab das Model auch gefunden: https://github.com/Niko1221/Strata
der link ist richtig. die annahme, dass es sich um ein modell handelt ist völlig falsch.
es ist eine inference engine, die auf llama.cpp aufsetzt und unterschiedliche models hosten kann.
diese engine ist technologisch bahnbrechend, da sie die dreifache leistung gegenüber bisher aus modellen rausholt und große modelle schnell und effektiv auch mit kleinen gpu's laufen lassen kann.

Wie bekommst Du mit nur 32GB VRAM 70 Tokens/Min? Mit einem Apple M5 und 128GB (auf die CPU und GPU zugreifen) ja, aber so? Erklär mal bitte.
lies mal die doku von strata durch. das prinzip basiert auf einem splitting der llm-fähigkeiten in sogenannte unabhängige experts, die weniger speicher verbrauchen und schneller handeln können. unter https://github.com/Niko1221/Strata sind auch guides verlinkt.

Was hast du vor? Das Weiße Haus hacken? :D Für paar Plugins wäre das doch völlig überdimensioniert, oder?
glaubst du wirklich, dass ich nur plugins bauen möchte?

ich habe mit meiner lösung meine privatsphäre bei internetsuche und llm abfrage.
ich lass darauf audio-, text- und grafikprogramme darauf laufen.
was auch ganz nett ist - hin und wieder mal gebraucht, ist zb. deepseek ocr oder vektorgrafik-generierung.

ich kann damit ganz nebenbei professionelle bilder und eigene videos in extrem hoher qualität erzeugen.
da wird mir schwindelig, wenn ich mir anschaue, was hier manche leute für videogenerierung monatlich an abos zahlen.
 
  • Danke
Reaktionen: BodoH
  • #13
Interessant. Ich hab bei meinem neuen kleinen Soundbürorechner extra die Variante ohne lokale KI Funktion genommen. :D

Nachdem ich gestern der KI mal wieder beim failen einer einfachen Patchbaybestückung zusehen durfte (war nach 6 Versionen immer noch falsch) benutze ich weiterhin mein Gehirn und geh wieder zum Musikmachen über.
 
  • #14
welcher ärger bitte?

Na den hier:

es hat ein paar stunden gedauert, das ding einzurichten.

Was für Dich ein paar Stunden sind, ist für andere ein unüberwindliches Hindernis. Den fehlen die Kenntnisse dafür und jede Motivation sowas überhaupt anzufassen.

Aus meiner Sicht gibt es keinen Grund dafür, nur weil Du das kannst und gemacht hast, alle anderen die das nicht können oder wollen zu Volldeppen zu erklären. Zumindest kommt das so rüber wenn man sich das durchliest was Du hier schreibtst.
 
  • #15
Na den hier:


Was für Dich ein paar Stunden sind, ist für andere ein unüberwindliches Hindernis. Den fehlen die Kenntnisse dafür und jede Motivation sowas überhaupt anzufassen.

Aus meiner Sicht gibt es keinen Grund dafür, nur weil Du das kannst und gemacht hast, alle anderen die das nicht können oder wollen zu Volldeppen zu erklären. Zumindest kommt das so rüber wenn man sich das durchliest was Du hier schreibtst.
Na ja, die KI kann jedem Deppen erklären, was er wann genau machen muss...
 
  • #16
und du willst mir hier auch nicht ernsthaft verkaufen, dass du mit den limitierungen der modellbenutzung beim 23 euro abo dauerhaft zurechtkommst...
Für das was ich gemacht habe, also einige Plugins bauen, reichte das aus und ich hab eigentlich auch keine höheren Pläne.
Bei dir ist das was ganz anderes, da rechnet sich und lohnt sich der beeindruckende Aufwand bestimmt.
 
  • #17
scherzkeks...

hier ein kurzer test - wurde allerdings mit einem coding-modell gemacht (hat mich gewundert, dass die sprache dafür so gewählt ist).
eine von mir generierte grafik wurde mit dem lokalen openwebui chat (funktioniert wie chatgpt) analysiert:
1793107034620.webp

btw. ich kann auch videos auf inhalte analysieren lassen...

und hier ein kurzer versuch, aus der grafik mit dem lokalen minimax h3 ein video (incl. ton) zu machen:


hier ein screenshot von meiner lokalen suchmaschine:
1793108244258.webp


VST PLUG

meine priorität liegt nicht darin, vst-plugs zu erstellen. testweise habe ich das mal gemacht.

hier ein echo , das mit juce nach meiner idee (2 delays kombiniert als ping pong oder dual stereo und per default in der daw gesynct) lokal in 4h erstellt wurde.


versionen für windows und linux jeweils mit oder ohne installer. auf mac-prozedur und developer account hatte ich keinen bock.
 
  • Interessant
Reaktionen: BodoH
×
Dir gefällt Recording.de? ❤️ Lasse dir unsere neuesten Inhalte in der Google-Suche ganz oben anzeigen!

Neue Antworten


Oft gelesene Themen

Zurück
Oben